嵌入模型
這頁的用途
嵌入模型 (Embedding Model) 負責把文字轉成一串數字(向量),讓系統能用「語意相近」而不只是「字面相同」來比對內容。這是知識庫 (Knowledge Base) 與檢索器 (Retriever) 做語意搜尋的基礎,例如讓使用者問「退貨要多久」也能找到標題寫「退款處理時程」的文件。
常見情境:
- 建立可語意搜尋的內部知識庫(法規、FAQ、產品手冊)。
- 讓檢索器依語意找出最相關的段落,再交給大型語言模型 (LLM) 回答。
目前嵌入模型僅提供 Amazon Bedrock - Cohere 一種類型。建立時填名稱、選類型後,畫面會出現該模型的連線與向量參數欄位。
開始前
前置需求
嵌入模型透過 Amazon Bedrock 的 Cohere 模型提供,需要可存取對應 AWS 區域 (Region) 的環境。索引與查詢請使用同一個嵌入模型,比對結果才會一致(見使用效果)。
操作步驟
-
從左側資源選單進入「嵌入模型」清單頁,點建立入口(空清單時是有文字的建立按鈕;清單已有項目時是右上角無文字的「+」圖示)開啟建立表單。剛開啟的表單只有「名稱」、「標籤」與「類型」三欄。
-
在「名稱」欄輸入容易辨識的名稱(例如
kb-embedding)。 -
在「類型」下拉選單選擇
Amazon Bedrock - Cohere(目前唯一可選)。選好後才會出現下方的模型與向量參數欄位。建立後類型不可更改。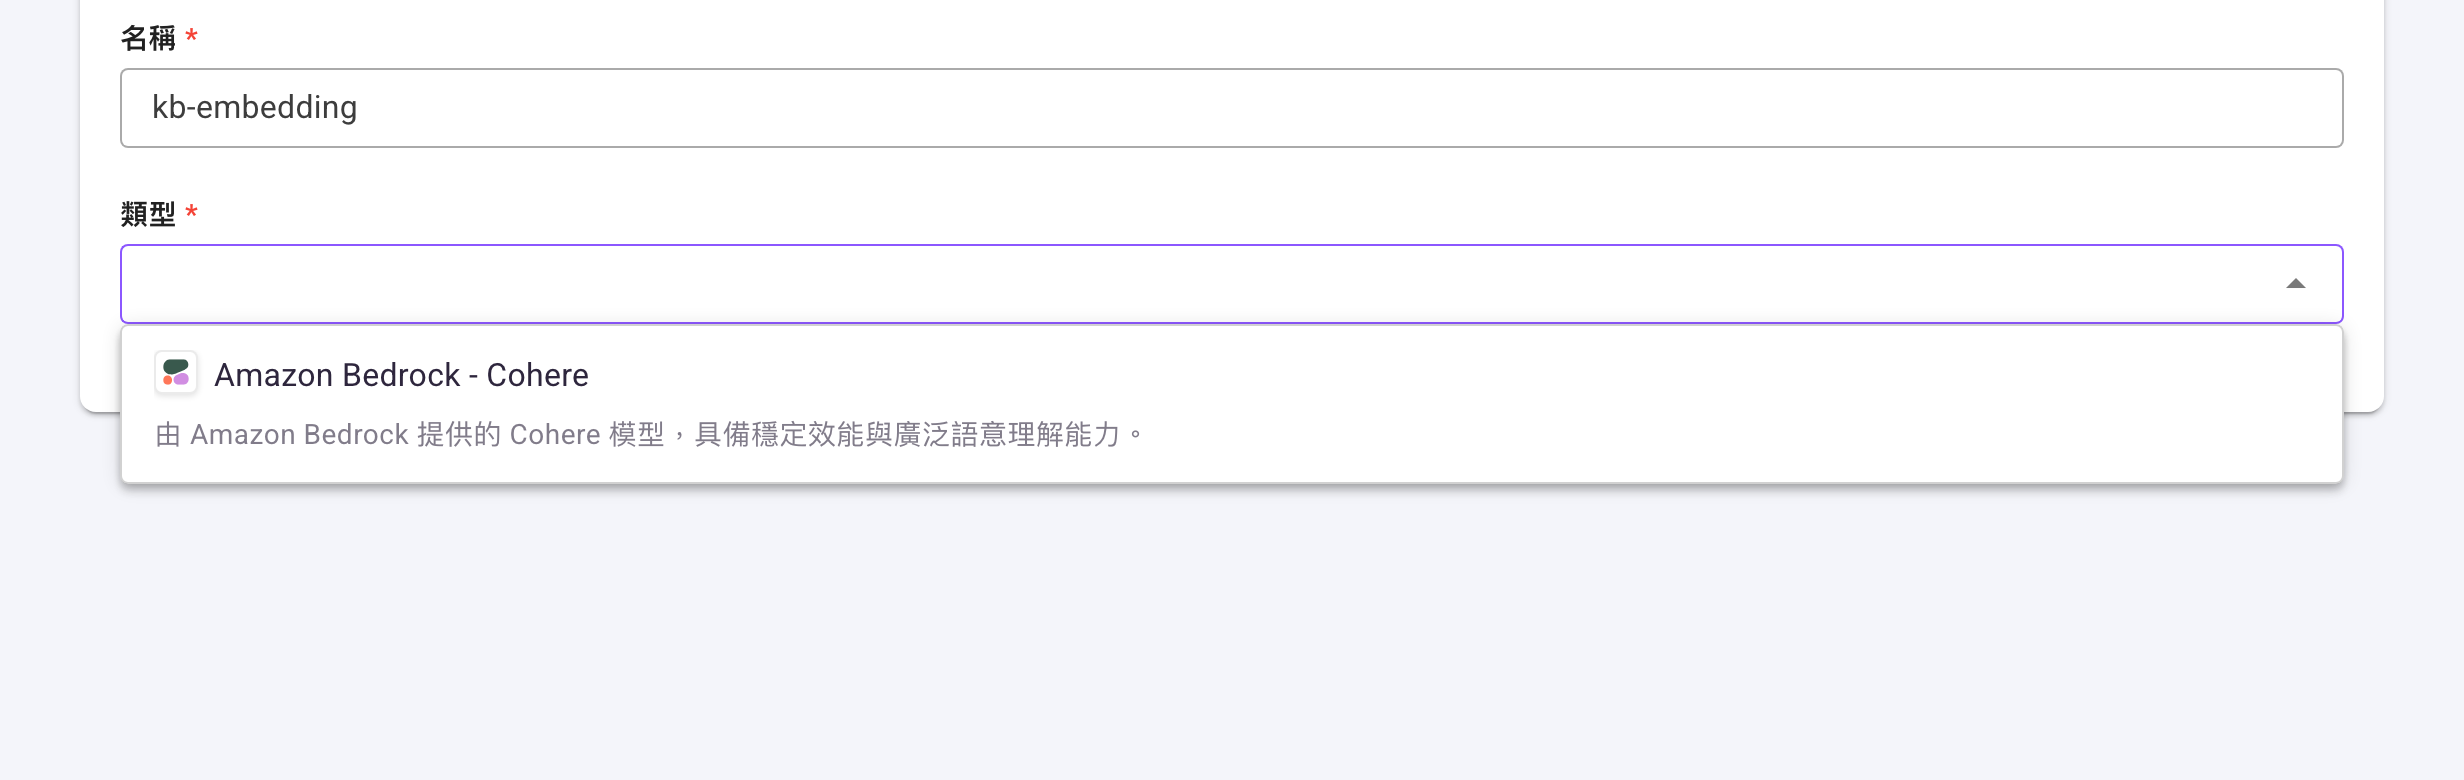
-
在「模型」選一個 Cohere 嵌入模型,再依序確認「嵌入類型」「向量資料類型」「地區」「輸入類型」「截斷處理」(多數已自動帶出預設值,只需選「地區」)。
-
視需要展開「進階設定」摺疊區塊,勾選並調整「最大 Token 數」與「輸出維度」(不勾選則沿用模型預設)。下圖為展開「進階設定」、兩個參數都勾選後的完整表單:
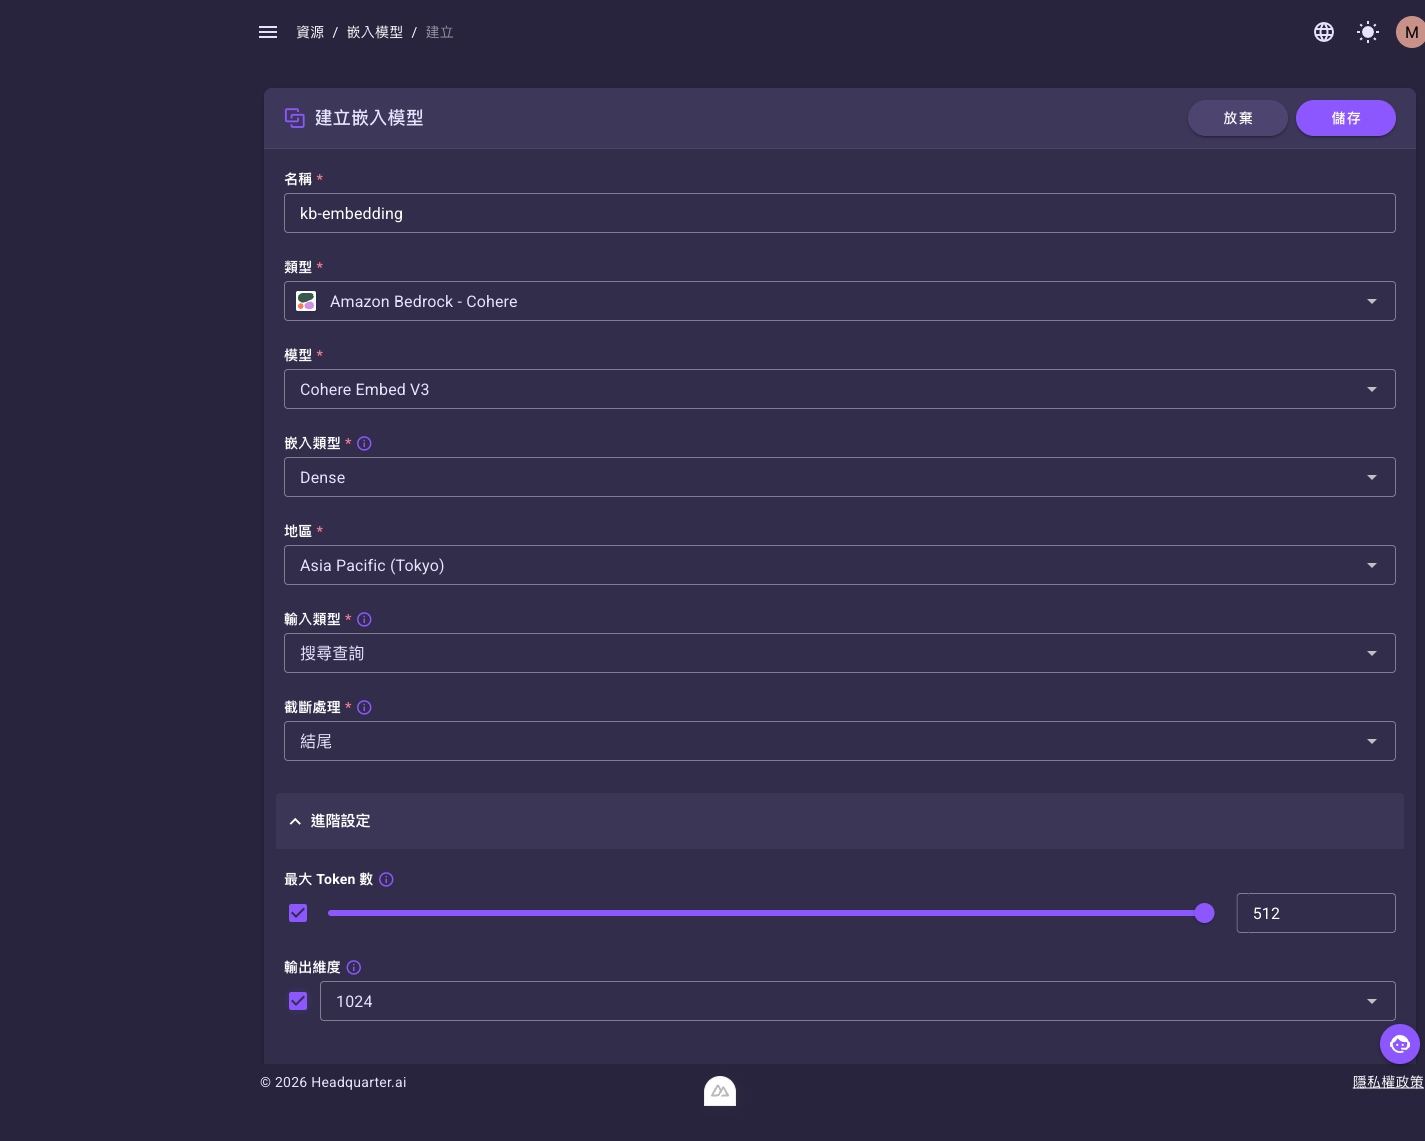
-
按右上角的「儲存」按鈕完成建立(見上方圖右上角)。
完整欄位說明
共同欄位
| 欄位 | 必填 | 預設 | 說明 |
|---|---|---|---|
| 名稱 | 是 | 無 | 此嵌入模型的識別名稱。最多 64 個字,不可用 default 開頭。 |
| 標籤 | 否 | 無 | 分類用的小標,貼上後可在清單頁用「標籤」把同一群資源一次篩出來。填法與數量/長度限制見「標籤」欄位。 |
| 類型 | 是 | 無 | 嵌入模型供應商類型。目前僅提供 Amazon Bedrock - Cohere。建立後無法修改。 |
Amazon Bedrock - Cohere 欄位
選擇此類型後會出現下列欄位:
| 欄位 | 必填 | 預設 | 說明 |
|---|---|---|---|
| 模型 | 是 | 無 | 要使用的 Cohere 嵌入模型,三選一:Cohere Embed V3、Global Cohere Embed V4、US Cohere Embed V4。不同模型支援的地區與輸出維度選項不同。 |
| 嵌入類型 | 是 | Dense | 嵌入向量的型態。目前固定為 Dense(密集向量,適合語意相似度與檢索)。 |
| 向量資料類型 | 是 | Float | 產生的向量要以哪種數字格式儲存進知識庫的向量索引(OpenSearch)。一般情境用預設的 Float 即可;四個選項的差異與版本需求見下表。建立後仍可修改,但改了會觸發相關知識庫完整同步(見下方警告)。 |
| 地區 | 是 | 無 | 模型所在的 AWS 區域。可選清單會依「模型」自動帶出該模型支援的區域(畫面顯示為友善名稱,如 Asia Pacific (Tokyo)、US West (Oregon))。請選實際可存取的區域。 |
| 輸入類型 | 是 | 搜尋查詢 | 告訴模型這批文字的用途,以便最佳化嵌入結果。可選 搜尋查詢、分類、分群。 |
| 截斷處理 | 是 | 結尾 | 當輸入超過模型可處理的長度時要從哪一端截掉。下拉的順序是 開頭、結尾(預設已選 結尾)。 |
「向量資料類型」下拉有四個選項(每個選項下方都有一行副標題說明),依序為:
| 選項 | 說明 |
|---|---|
| Float | 使用完整精度向量與餘弦相似度。預設值,不需特定 OpenSearch 版本,一般情境用它即可。 |
| Int8 | 使用有號 8 位元向量與餘弦相似度,需使用 OpenSearch 2.9 以上版本。 |
| Binary | 使用有號位元封裝向量與漢明距離,需使用 OpenSearch 2.16 以上版本。 |
| Unsigned Binary | 使用無號位元封裝向量與漢明距離,需使用 OpenSearch 2.16 以上版本。 |
事後變更「向量資料類型」會重建向量索引
編輯既有的嵌入模型時,只要把「向量資料類型」改成與原本不同的值,該欄位下方就會立刻出現一則警告(還沒按「儲存」就會顯示;改回原值即消失):
變更向量資料類型後,相關知識庫的下一次同步將自動執行完整同步,並重新建立向量索引。請確認 OpenSearch 支援所選的資料類型。若強制執行增量同步,會因無法原地修改向量索引 mapping 而失敗。
另外,Binary 與 Unsigned Binary 改用漢明距離計算相似度,分數尺度與 Float 不同——工作流程中檢索 (Retrieval) 任務與排序器 (Ranker) 任務既有的「相似度門檻值」需要據此重新調整。
輸入類型怎麼選
多數知識庫/檢索情境用預設的 搜尋查詢 即可(用於在知識資料庫中查詢相關文件)。分類 是把向量當文字分類器的輸入,分群 是用來分析向量的群集——只有做這兩類進階分析時才需要改。
進階設定(摺疊區塊)
以下兩個參數位於「進階設定」摺疊區塊內,需先選好「模型」才能調整;各欄前方都有勾選框,勾選後才會套用,未勾選則沿用模型預設。
| 欄位 | 必填 | 預設 | 說明 |
|---|---|---|---|
| 最大 Token 數 | 否 | 未啟用(勾選後 512) | 模型一次最多處理的 Token 數(Token 是分詞後的最小單位,例如一個字或標點)。範圍依模型而定。 |
| 輸出維度 | 否 | 未啟用(勾選後 1024) | 輸出向量的長度,也就是每筆結果包含多少個數值。可選值依模型而定。 |
可調範圍依模型而定
Cohere Embed V3:最大 Token 數 128–512;輸出維度僅1024。Global Cohere Embed V4/US Cohere Embed V4:最大 Token 數 128–128000;輸出維度可選256、512、1024、1536。
最小設定範例
給知識庫用的最小設定:名稱 kb-embedding、類型 Amazon Bedrock - Cohere、模型 Cohere Embed V3、地區選可存取的區域(如 Asia Pacific (Tokyo)),其餘維持預設(嵌入類型 Dense、向量資料類型 Float、輸入類型 搜尋查詢、截斷處理 結尾),進階設定不勾選。建立後即可在知識庫與檢索器中選用。
嵌入模型詳細頁
建立完成後點進某個嵌入模型,詳細頁上方有三個頁籤;下圖為「一般」頁籤的「詳細資料」卡片,可看到 ID、名稱、標籤、類型、地區、模型與向量參數、狀態、建立者、更新者與最後更新:
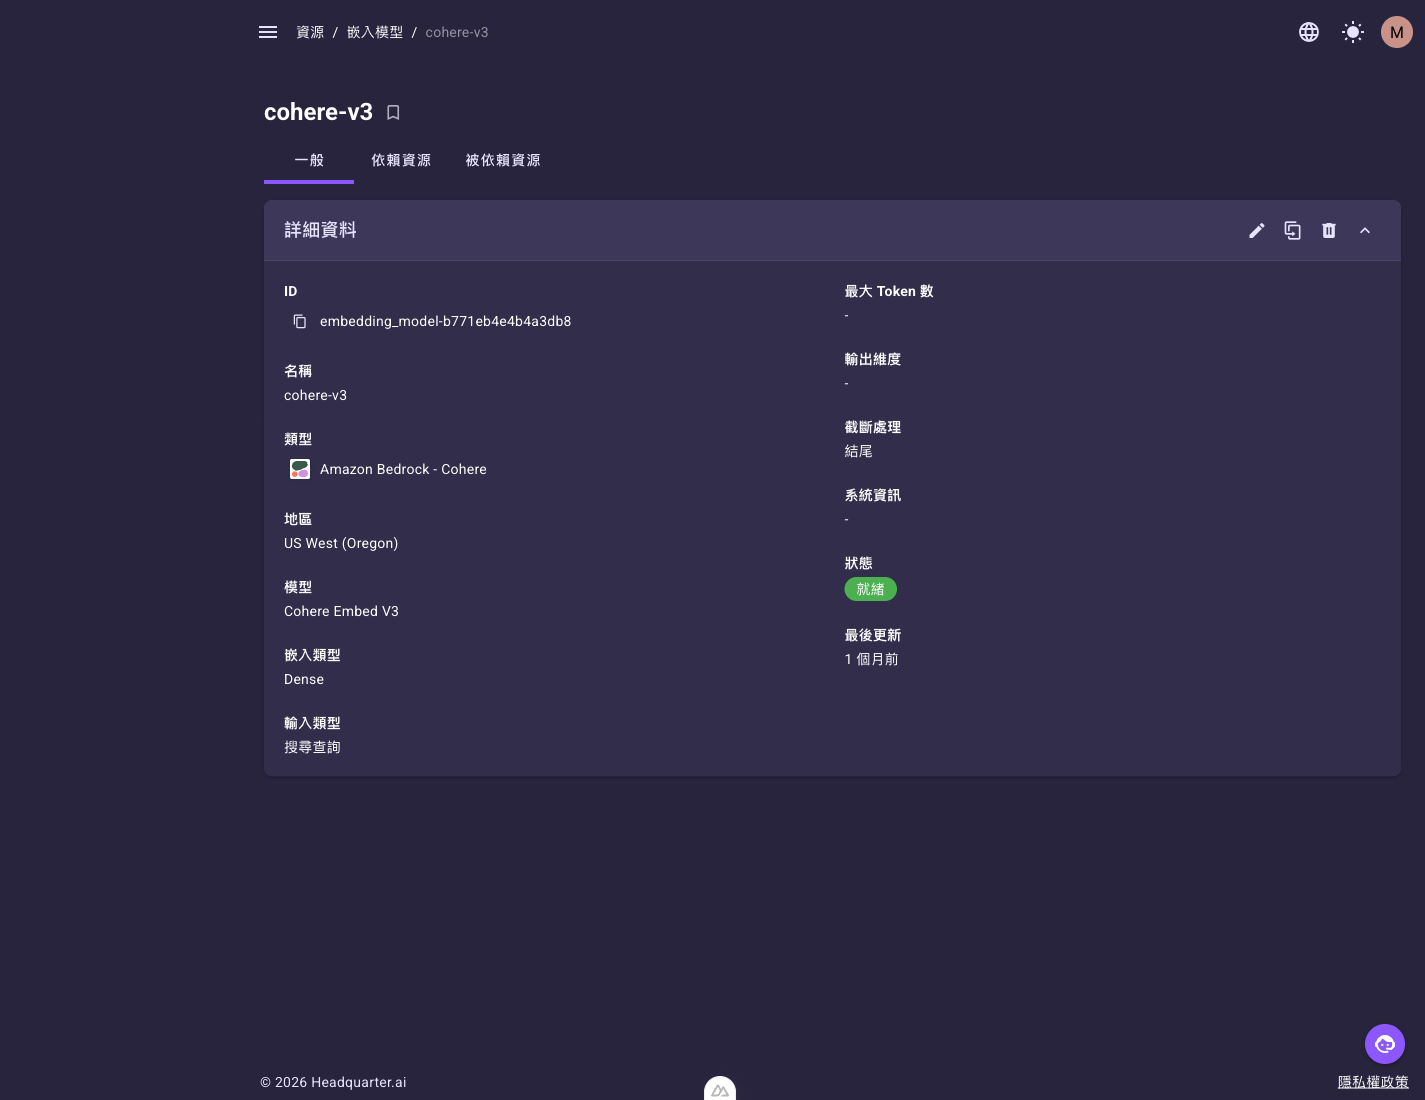
| 頁籤 | 內容 |
|---|---|
| 一般 | 嵌入模型的基本資料:ID、名稱、標籤、類型、地區、模型、嵌入類型、向量資料類型、輸入類型、最大 Token 數、輸出維度、截斷處理、系統資訊、狀態、建立者、更新者與最後更新。 |
| 依賴資源 | 這個嵌入模型用到的其他資源。 |
| 被依賴資源 | 反過來,有哪些資源用到這個嵌入模型(例如選用它的知識庫、檢索器、分割器或排序器)。 |
部署有啟用日誌功能時,最後還會多一個「日誌」頁籤,說明見通用介面元件 — 詳細頁的「日誌」頁籤。
「詳細資料」卡片右上角的圖示鈕由左到右為編輯()、複製()、刪除()與收合卡片的箭頭()。
系統預設的 default-embedding-model 只有「複製」
它是清單的第一筆,也最容易被先點進去。系統預設資源不能改也不能刪,所以它的卡片右上角沒有編輯與刪除,只有「複製」與收合箭頭——要動手改參數,請複製一份或自己建一個。
嵌入模型沒有「驗證」功能
與大型語言模型 (LLM) 或連結器 (Connector) 不同,嵌入模型的表單與詳細頁都不提供「驗證憑證/測試連線」按鈕——它沒有獨立的連線驗證入口。要確認它能不能用,看它在下游被選用後產生的索引與檢索結果(見下方使用效果)。
使用效果
嵌入模型不能單獨執行,它的價值在於被下游功能拿去把文字轉成向量。同一個嵌入模型會出現在兩個關鍵環節:
- 索引文件時:知識庫 (Knowledge Base) 透過載入器 (Loader) 把資料來源的內容切塊、用嵌入模型轉成向量寫進倉庫;其中分割器 (Chunker) 的 Consecutive/Cumulative/Minimal Partition 類型也會用嵌入模型來判斷語意邊界。
- 查詢時:檢索器 (Retriever) 把使用者的問題用嵌入模型轉成查詢向量,再去倉庫裡比對最相近的段落;排序器 (Ranker) 的 Embedding 類型也用嵌入模型來重新排序候選結果。
索引與查詢要用同一個嵌入模型
向量比對是用「同一套座標系」算距離的。寫入知識庫時用哪個嵌入模型,查詢時就要用同一個(同模型、同維度、同地區設定),否則查詢向量和文件向量落在不同空間,比對結果會失準。建議在知識庫、檢索器、相關分割器/排序器都選用同一個嵌入模型。
要看實際的檢索問答效果,見知識庫 (Knowledge Base) 與檢索器 (Retriever) 頁面的「使用效果」段——那裡示範了用嵌入模型索引後,Agent 如何查到正確文件並回答。
建完之後怎麼確認自己建對了:因為沒有驗證按鈕,最快的自我檢查有兩步——
- 到這個嵌入模型詳細頁的「被依賴資源」頁籤,確認它已被預期的知識庫/檢索器/分割器/排序器選用(空的就是還沒有人用到它)。
- 用選了它的載入器跑一次同步:同步任務細節頁的「資料物件數量」「搜尋區塊數量」大於 0,就代表這個嵌入模型能正常把內容轉成向量寫進知識庫(設定有誤時同步會失敗)。
下一步
- 知識庫 (Knowledge Base):選用此嵌入模型來索引文件。
- 檢索器 (Retriever):選用同一個嵌入模型來處理查詢。
- 分割器 (Chunker):Consecutive/Cumulative/Minimal Partition 類型需指定嵌入模型。
- 排序器 (Ranker):Embedding 類型用嵌入模型重新排序檢索結果。